Prompt de réflexion ou d'exécution : le bon modèle d'IA
Face à l'inflation des coûts de tokens, découvrez comment découpler prompt de réflexion et prompt d'exécution grâce à une matrice simple et opérationnelle.
Prompt de réflexion ou d’exécution : le bon modèle d’IA
1. Contexte & Objectif de Terrain
Dans la plupart des organisations, la gestion des modèles de langage ressemble étrangement aux débuts de l’informatique de bureau : une seule solution est déployée pour tous les usages, sans distinction de charge ni d’enjeu. Quand une équipe découvre un modèle de dernière génération, capable d’enchaîner des étapes de raisonnement interne poussé, le réflexe immédiat est de tout lui confier. On lui soumet des synthèses stratégiques complexes, mais aussi des tris d’e-mails, des extractions de dates de péremption ou des nettoyages de tableaux de bord.
Le résultat ne se fait pas attendre. À la fin du mois, le responsable d’activité ou le responsable qualité constate deux anomalies majeures : des temps de réponse devenus interminables sur des opérations pourtant courantes, et une facture de tokens qui s’envole de manière exponentielle.
Le volume des tokens d’output facturés explose, non pas parce que les réponses fournies sont plus longues, mais parce que les modèles récents intègrent des chaînes de pensée invisibles, facturées au prix fort.
À l’autre extrémité du spectre, les utilisateurs échaudés par ces coûts tentent de basculer l’ensemble de leurs flux sur des modèles légers et ultra-rapides. Ils constatent alors un autre mur : confrontés à des analyses causales ouvertes ou à des contradictions réglementaires, ces modèles compacts s’effondrent. Ils produisent des réponses superficielles, ignorent des paramètres cruciaux ou valident des anomalies graves avec une assurance trompeuse.
En PME industrielle, un responsable QSE ou des opérations se retrouve vite pris en étau entre ces deux impasses. L’objectif n’est pas d’expérimenter pour la beauté du geste, mais de garantir la conformité de son système de management sans grever son budget d’exploitation.
Pour sortir de ce piège, il faut comprendre une vérité élémentaire : le problème ne vient pas seulement de la taille du modèle choisi, mais de l’inadéquation structurelle entre la nature du prompt rédigé et la mécanique du modèle qui le reçoit.
2. Anatomie de l’Échec & Fausses Pistes (Le Mur)
L’erreur la plus coûteuse consiste à traiter tous les prompts comme des instructions équivalentes. Dans la pratique quotidienne, deux types d’invites fondamentalement distinctes coexistent : les invites de réflexion et les invites d’exécution.
Une invite de réflexion demande au système d’explorer un espace d’hypothèses, de peser des arbitrages contradictoires, d’identifier des causes racines ou de structurer une stratégie d’analyse. C’est une démarche heuristique, arborescente et ouverte.
Une invite d’exécution, au contraire, exige l’application stricte d’un contrat prédéfini : extraire trois champs précis, vérifier la présence d’une signature, formater une date ou renvoyer un tableau selon un schéma rigide. C’est une tâche mécanique, déterministe et fermée.
Le mur apparaît dès que l’on croise mal ces deux natures d’invites avec les familles de modèles disponibles sur le marché.
Première fausse piste : confier une invite d’exécution à un modèle de réflexion
Supposons que vous deviez traiter un lot de 500 fiches d’anomalies de livraison. Pour chaque fiche, le besoin consiste simplement à extraire le code article, la date de réception et le statut d’acceptation.
S’il envoie cette consigne à un grand modèle de raisonnement, le modèle va déclencher son protocole de réflexion interne. Il va analyser la syntaxe de la phrase, simuler plusieurs interprétations possibles, s’interroger sur l’intention sous-jacente de l’opérateur et vérifier trois fois si la date suit le calendrier grégorien.
Pendant ces six secondes de silence, le modèle génère 1 500 tokens de pensée invisible. Pourtant, la réponse finale tient en vingt mots. Vous venez de payer le tarif maximal d’output pour une tâche qu’un filtre de saisie bureautique aurait pu exécuter en trois millisecondes. Multipliée par 500 fiches, cette dérive transforme une routine d’atelier en gouffre financier.
Deuxième fausse piste : confier une invite de réflexion à un modèle d’exécution rapide
Face à l’envolée de la facture, la tentation inverse consiste à basculer une tâche complexe vers un petit modèle rapide. On lui soumet par exemple un rapport d’accident du travail comportant des témoignages contradictoires et on lui demande : « Identifie les causes profondes et propose trois axes prioritaires selon la méthode des 5 Pourquoi ».
Le modèle compact ne dispose pas d’espace d’inférence intermédiaire pour déplier son raisonnement. Il prédit immédiatement le mot suivant le plus probable statistiquement. En une fraction de seconde, il renvoie une liste à puces convenue : « Manque de vigilance de l’opérateur, nécessité de rappeler les consignes de sécurité, mettre à jour le classeur ».
Le résultat est creux, le biais du blâme individuel n’est pas interrogé, et le responsable qualité se retrouve avec une analyse inutilisable qui met en péril sa prochaine revue de direction.
La fausse piste bâtarde : le prompt hybride
La pire erreur reste le prompt monolithique qui tente de tout faire en une seule passe : « Réfléchis aux causes de cette panne, évalue trois scénarios, tranche sur la solution la plus économique, puis formate le tout sous forme de tableau strict à quatre colonnes sans ajouter un seul mot d’introduction ».
Ce mélange des genres surcharge l’attention du modèle. Dans la moitié des cas, le modèle privilégie la réflexion et oublie la contrainte de formatage. Dans l’autre moitié, il s’efforce de respecter le tableau et mutile son analyse causale pour rentrer dans les cases. Le résultat est doublement insatisfaisant, imprévisible et impossible à automatiser de manière fiable.
3. Décryptage Méthodologique par l’Analogie QSE
Pour un ingénieur ou un responsable qualité, cette situation n’a pourtant rien d’inédit. Elle rappelle exactement l’organisation du travail au sein d’une usine mécanique certifiée ISO 9001.
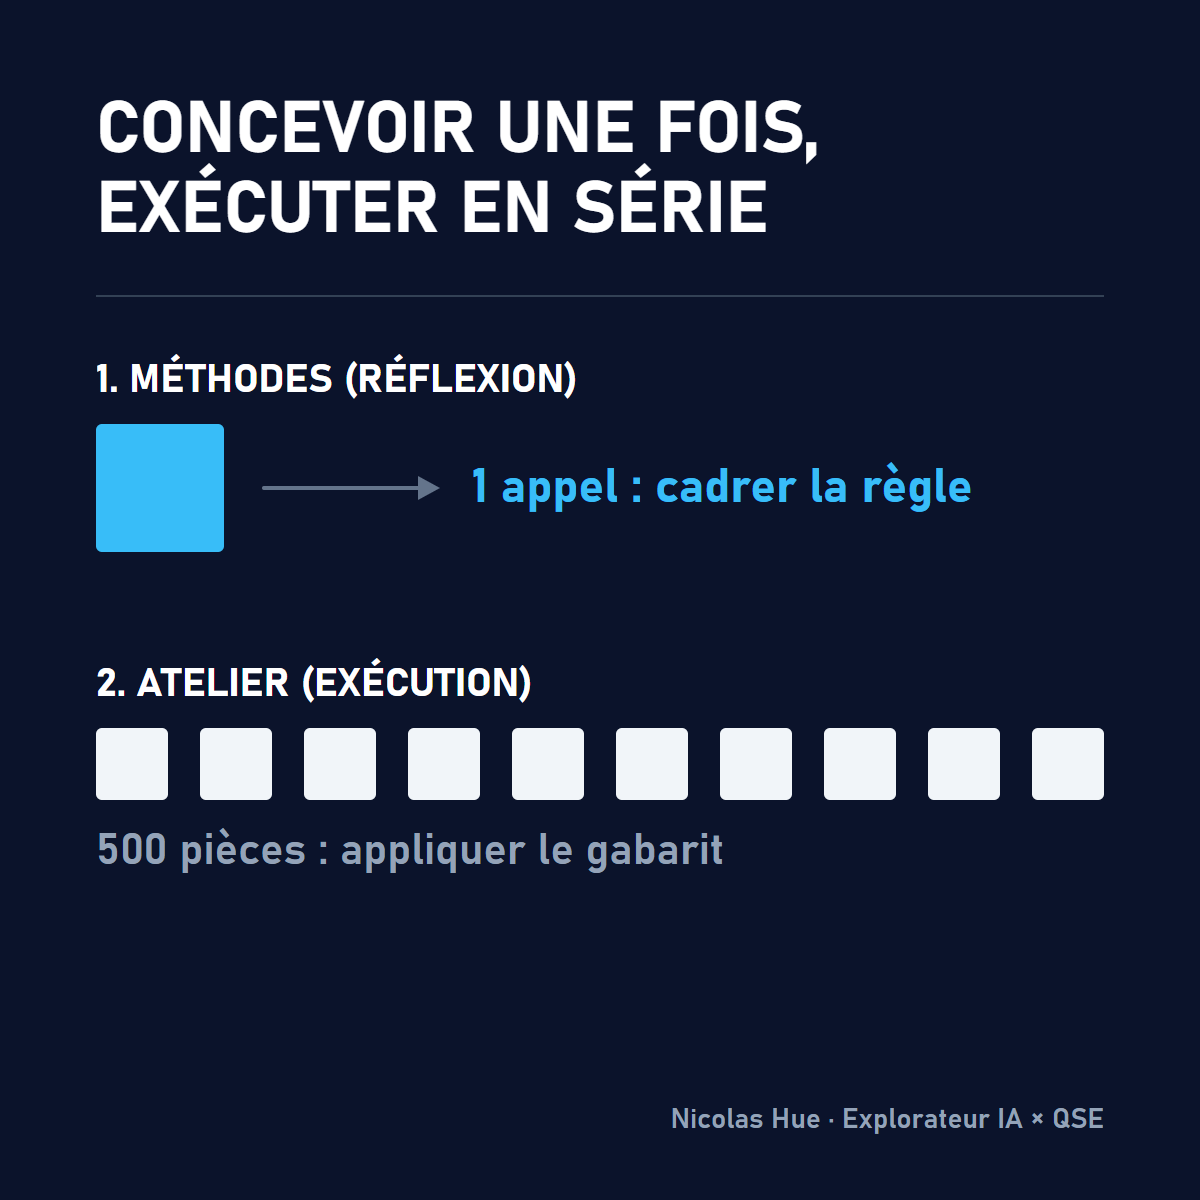
Dans un atelier industriel performant, on ne demande jamais à la même personne, au même moment et avec les mêmes outils, de concevoir le procédé et de fabriquer la pièce en série. La pérennité du système repose sur une séparation claire des responsabilités entre deux fonctions bien distinctes : le Bureau des Méthodes et l’Opérateur au Poste de Travail.
Le Bureau des Méthodes (L’analogue du prompt de réflexion)
Le rôle de l’ingénieur méthodes intervient en amont de la production. Face à un nouveau plan client ou à une matière première complexe, il étudie les contraintes, analyse les risques de déformation, teste plusieurs gammes d’usinage, consulte les normes et définit les tolérances critiques.
Ce travail intellectuel demande du temps, de l’expertise et des allers-retours méthodiques. Son coût unitaire est élevé. Mais cette dépense est vertueuse parce qu’elle n’est engagée qu’une seule fois : elle sert à concevoir le gabarit, à valider le processus et à rédiger la consigne opératoire définitive.
Vouloir supprimer ce temps de réflexion amont conduit tout droit à des rebuts en cascade sur la ligne d’assemblage.
L’Opérateur au Poste (L’analogue du prompt d’exécution)
Une fois la gamme de fabrication validée par les méthodes, elle descend sur la ligne de production. L’opérateur reçoit une fiche d’instruction au poste, claire, concise et dépourvue de toute ambiguïté.
L’opérateur n’a pas pour mission de redéfinir la nuance de l’acier ou de recalculer la résistance des matériaux entre chaque coup de presse. Il applique la consigne : il positionne la pièce contre la butée mécanique, actionne la commande et vérifie la conformité avec un calibre GO / NO-GO.
Ce geste est ultra-rapide, parfaitement répétable, prévisible et d’un coût marginal dérisoire.
L’aberration organisationnelle transposée à l’IA
Imaginez maintenant une usine où le directeur déciderait d’envoyer l’ingénieur méthodes en chef, avec son salaire et son logiciel de calcul d’éléments finis, pour visser manuellement 10 000 écrous sur le convoyeur. L’entreprise déposerait le bilan avant la fin du trimestre.
Inversement, imaginez confier la validation des plans d’un nouveau réacteur sous pression à un stagiaire débutant en lui donnant trente secondes pour trancher sans droit à l’erreur. La catastrophe industrielle serait immédiate.
C’est pourtant très exactement ce que font les organisations lorsqu’elles utilisent un grand modèle de raisonnement pour accomplir des tâches d’extraction en masse, ou lorsqu’elles demandent à un micro-modèle d’arbitrer des dilemmes d’assurance qualité.
4. Le Pivot Architectural & L’Implémentation Déterministe
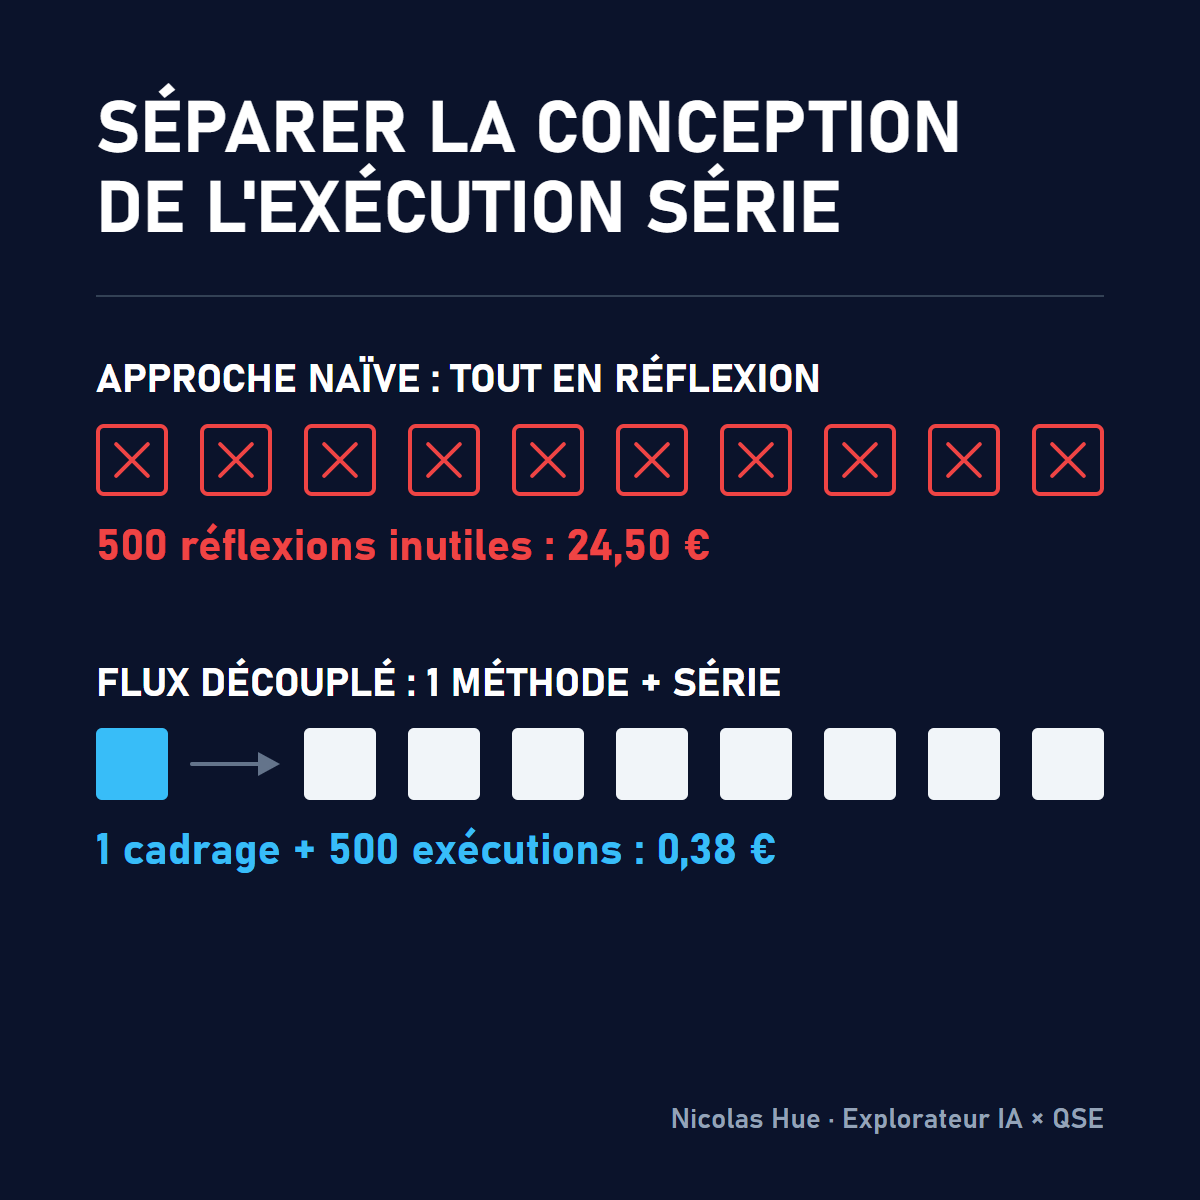
La réponse à l’inflation des tokens ne réside donc pas dans une course au modèle parfait qui saurait tout faire. La réponse réside dans un principe d’architecture simple : le découpage séquentiel en deux étages étanches.
Ce principe consiste à séparer rigoureusement la phase de conception réflexive de la phase d’exécution série.
Étape 1 : Le prompt de réflexion pour figer la règle
Dans cette première phase, vous convoquez la pleine puissance cognitive d’un modèle de raisonnement. Vous ne lui donnez pas 500 documents à traiter : vous lui soumettez un échantillon représentatif de cinq cas complexes et vous lui demandez de construire la grille de lecture.
L’invite de réflexion est délibérément orientée vers l’investigation : « Voici cinq fiches d’incidents fournisseurs comportant des descriptions hétérogènes. Analyse les critères objectifs qui permettent de distinguer un défaut critique d’un défaut mineur au sens de la norme ISO 9001. Identifie les pièges de formulation fréquents et propose une grille d’évaluation binaire fermée, avec une liste exhaustive de cinq codes de non-conformité possibles et un format de sortie tabulaire strict ».
Ici, le modèle de raisonnement déploie ses tokens de pensée. Il explore les risques, confronte les formulations et purge les zones grises. Cette étape coûte quelques dizaines de centimes d’euro en tokens. Mais elle produit un livrable pérenne : une procédure de contrôle stabilisée et testée.
Étape 2 : Le prompt d’exécution pour traiter les volumes
Une fois la grille arrêtée, le modèle de raisonnement est éteint. Pour traiter les 500 ou 5 000 fiches réelles de l’année, vous basculez sur un modèle compact et ultra-économique.
L’invite d’exécution devient un contrat binaire sans échappatoire : « Tu es un opérateur de contrôle de données. Analyse le texte fourni ci-dessous en appliquant strictement la grille de référence suivante. Règles impératives :
- Choisis exactement un code parmi : NC-01, NC-02, NC-03, NC-04, NC-05.
- Si le texte ne contient aucun élément probant, indique NC-00.
- Ne rédige aucune introduction, aucune explication, aucune formule de politesse.
- Remplis uniquement les quatre colonnes du tableau : Référence | Date | Code | Criticité ».
Face à cette consigne fermée, le modèle compact ne perd pas de temps en digressions. Il lit l’entrée, applique le gabarit et produit la sortie demandée en moins d’une seconde, sans générer le moindre token de pensée parasite.
5. Données Chiffrées, Benchmarks & Résultats Mesurés
Pour mesurer l’impact économique réel de cette séparation méthodique, analysons une simulation comparative menée sur un lot représentatif de 500 fiches de non-conformité fournisseurs.
Chaque fiche comprend environ 350 mots (environ 450 tokens de texte en entrée). L’objectif est d’extraire la cause immédiate déclarée, d’affecter un code de non-conformité normalisé et d’évaluer la criticité documentaire.
Trois architectures de traitement sont comparées :
- Architecture A (Monolithique Réflexion) : Les 500 fiches sont traitées individuellement par un modèle de raisonnement de pointe.
- Architecture B (Monolithique Naïve Rapide) : Les 500 fiches sont traitées individuellement par un modèle compact rapide, mais avec un prompt généraliste non stabilisé.
- Architecture C (Découplage Méthodes / Ligne) : Une phase de cadrage amont sur modèle de raisonnement (1 invite de réflexion), suivie du traitement des 500 fiches par un modèle compact via l’invite d’exécution calibrée.
Tableau comparatif des consommations et des coûts
| Critère de performance | Architecture A (Tout Réflexion) | Architecture B (Tout Compact Naïf) | Architecture C (Découplage Cadré) | Facteur de gain (C vs A) |
|---|---|---|---|---|
| Tokens d’entrée cumulés | 225 000 tokens | 225 000 tokens | 235 000 tokens (inclut le cadrage) | Identique à 4% près |
| Tokens de pensée internes | 850 000 tokens invisibles | 0 token | 3 800 tokens (cadrage initial seul) | Réduction de 99,5% |
| Tokens de sortie utiles | 45 000 tokens | 65 000 tokens (bavardage) | 32 000 tokens (schéma strict) | Réduction de 28% |
| Total des tokens facturés | 1 120 000 tokens | 290 000 tokens | 270 800 tokens | Volume divisé par 4,1 |
| Temps de traitement total | 48 minutes | 4,2 minutes | 4,8 minutes | Vitesse multipliée par 10 |
| Taux de conformité au gabarit | 98% | 64% (formats variables) | 99,2% (contrat respecté) | Qualité supérieure |
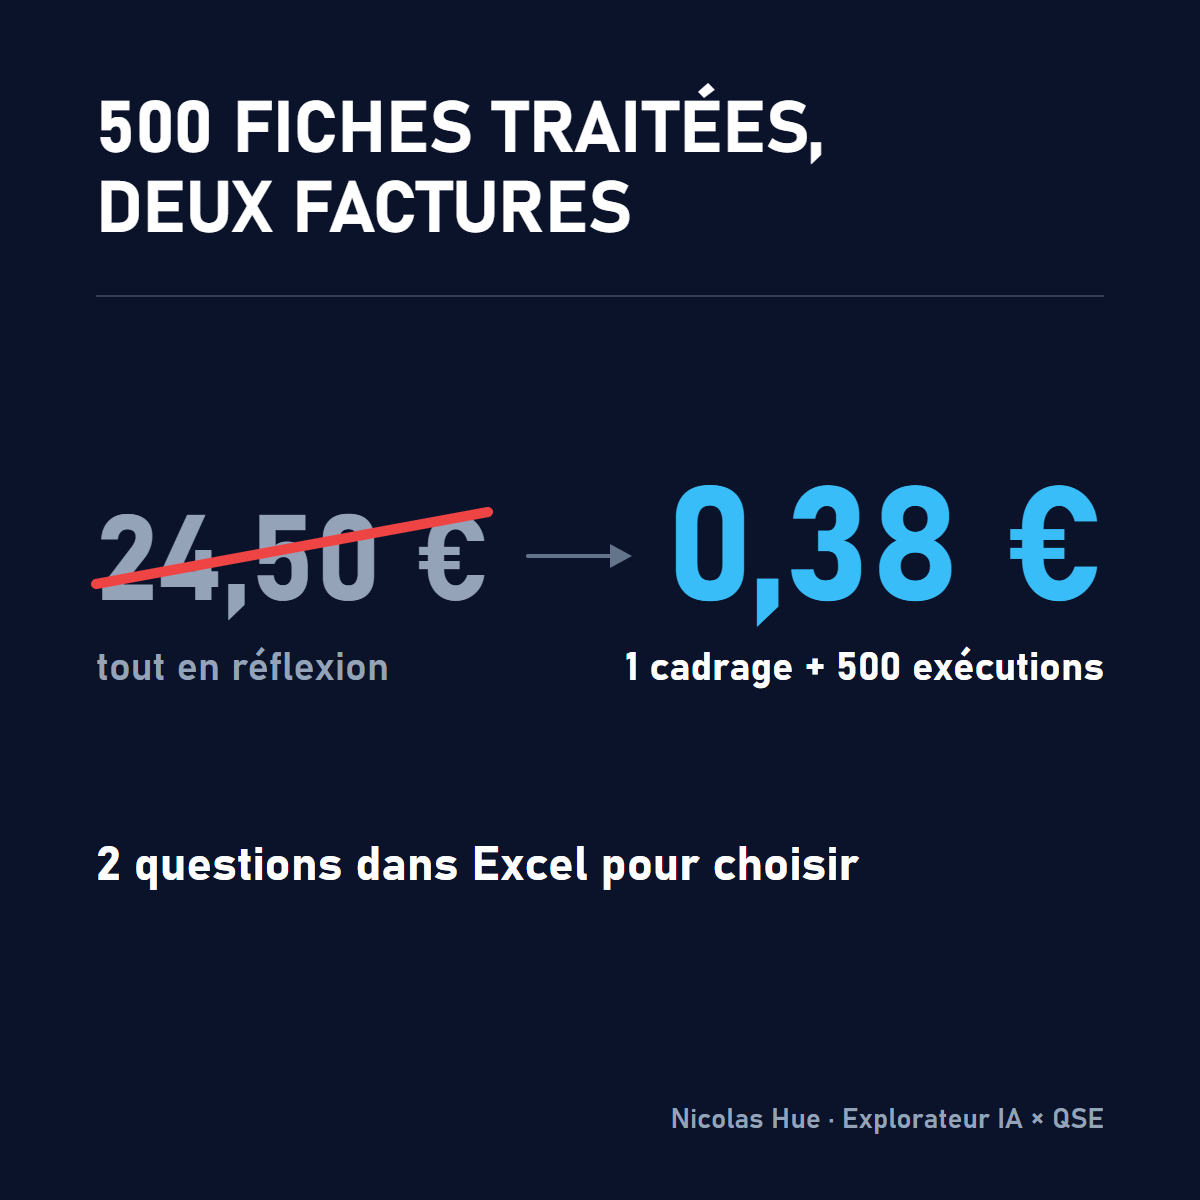
| Coût financier estimé | 24,50 euros | 0,25 euro | 0,38 euro | Facture divisée par 64 |
Analyse des compromis opérationnels
Les chiffres révèlent deux enseignements majeurs :
Premièrement, l’Architecture A représente un gaspillage massif de ressources. Les 850 000 tokens de pensée facturés au tarif fort n’ont apporté aucune valeur ajoutée sur des tâches d’application mécanique. L’entreprise paie 24,50 euros pour un travail qui aurait pu coûter quelques centimes.
Deuxièmement, l’Architecture B, bien que très économique en apparence, échoue sur le plan de la qualité industrielle. Avec seulement 64% de conformité au gabarit de sortie, le temps passé à corriger manuellement les tableaux dans Excel annule immédiatement l’économie réalisée sur les tokens.
L’Architecture C offre l’équilibre parfait de l’amélioration continue : elle investit treize centimes d’euro dans une invite de réflexion initiale pour verrouiller le procédé, puis exécute l’ensemble du lot avec une précision quasi-parfaite pour un coût dérisoire de vingt-cinq centimes.
6. Déploiement Zéro-Terminal (Le Mode d’Emploi Opérationnel)
Vous n’avez besoin d’aucune compétence en programmation logicielle, ni d’aucun environnement en ligne de commande, pour mettre en œuvre cette rigueur dans votre service. La démarche s’opère intégralement à travers les outils bureautiques courants et les interfaces de discussion standard.
1. La Matrice de Qualification 2x2 sous Excel
Avant de soumettre une tâche à un outil d’intelligence artificielle, appliquez une grille d’orientation élémentaire en deux questions binaires :
| Question d’évaluation | Option Basse (Valeur = 0) | Option Haute (Valeur = 1) |
|---|---|---|
| Q1. Espace de liberté de la tâche | Application d’une consigne connue, extraction, mise en forme | Exploration d’inconnues, arbitrage de dilemmes, enquête causale |
| Q2. Nature du format attendu | Tableau strict, extraction de champs, choix dans une liste | Analyse argumentée, synthèse ouverte, recommandations nuancées |
La règle d’aiguillage opérationnelle :
- Score = 0 (Application + Format strict) : Prompt d’exécution obligatoire sur modèle compact. Zéro réflexion demandée. Contrat de sortie fermé.
- Score = 1 (Cas intermédiaire) : Décomposer le problème. Utiliser d’abord un modèle compact pour extraire et nettoyer les données brutes, puis transmettre uniquement la synthèse ciblée au modèle expert si un arbitrage subsiste.
- Score = 2 (Exploration + Format ouvert) : Prompt de réflexion justifié sur modèle de raisonnement. Laisser au modèle le temps et l’espace nécessaires pour déplier sa chaîne causale.
2. Le gabarit de prompt d’exécution prêt à l’emploi pour le poste de travail
Pour verrouiller vos tâches répétitives sans dérive, conservez dans vos modèles de documents un gabarit standardisé en trois blocs :
[RÔLE & PÉRIMÈTRE]
Tu agis comme un opérateur de contrôle de données d'atelier. Ta fonction est d'extraire et de classifier des éléments factuels sans aucune interprétation subjective.

[DONNÉES EN ENTRÉE]
Texte à traiter : """Insérer le texte ici"""

[RÈGLES OPÉRATOIRES IMPÉRATIVES]
1. Identifie l'identifiant unique du dossier.
2. Classe l'anomalie parmi les catégories autorisées : [Matière, Machine, Main d'œuvre, Méthode, Milieu].
3. Si une information est absente, inscris impérativement "NON_RENSEIGNÉ".
4. Format de sortie : reproduis uniquement la ligne suivante sans aucun texte avant ni après :
ID | Catégorie | Date | Action_Requise
En collant ce gabarit dans une interface bureautique connectée à un modèle compact, vous éliminez les hallucinations de complaisance, supprimez les introductions inutiles et garantissez l’importation directe des résultats dans votre tableau Excel d’un simple copier-coller.
7. Les 3 Règles d’Or Actionnables & Conclusion
Face à une économie des tokens où les architectures de raisonnement deviennent de plus en plus coûteuses et sophistiquées, la frugalité n’est pas un renoncement technique : c’est le signe d’une maîtrise des processus industriels.
Pour concevoir des flux d’intelligence artificielle robustes, stables et financièrement soutenables, trois règles directrices s’imposent :
- Règle de séparation des temps : Ne demandez jamais à un modèle de réfléchir et d’exécuter dans la même invite. Réservez la réflexion au cadrage amont de la méthode (une fois), et confiez l’exécution au modèle le plus compact possible (mille fois).
- Règle du contrat de sortie fermé : Plus une tâche est répétitive, plus son format de sortie doit être mécaniquement verrouillé. Un prompt d’exécution efficace ne laisse aucun degré de liberté stylistique à l’outil.
- Règle du juste calibre : Ne payez jamais pour des tokens de pensée si un simple calibre GO / NO-GO suffit à qualifier la conformité du travail. La puissance d’investigation ne doit être mobilisée que là où réside une véritable ambiguïté humaine ou technique.
En appliquant la rigueur du management de la qualité aux architectures de prompts, les organisations transforment une technologie perçue comme magique et imprévisible en un outil de production déterministe, rentable et sous contrôle permanent.